
Read in English: SAM, BAM and CRAM Explained: A Practical Guide to Alignment Files
دائرہ کار: تعلیمی اور تحقیقی استعمال۔ Alignment فائل صرف یہ بتاتی ہے کہ aligner نے ہر read کو کہاں رکھا؛ یہ خود اس بات کا ثبوت نہیں کہ کوئی ویریئنٹ، gene expression میں تبدیلی یا structural تبدیلی حقیقی ہے۔
آخری جائزہ: 16 نومبر 2026
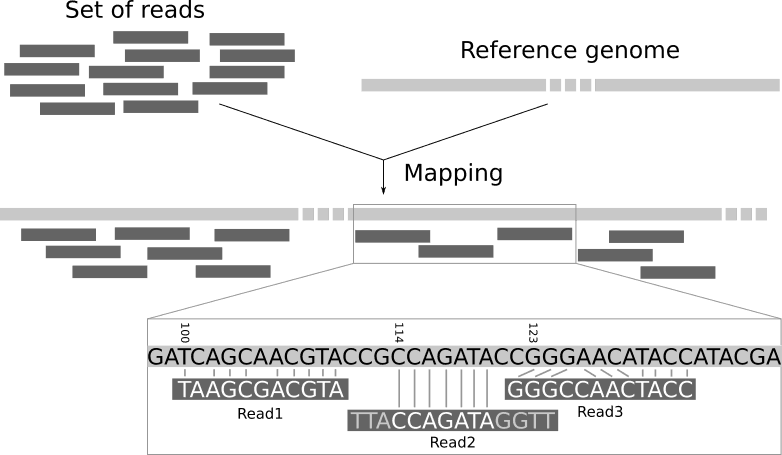
اس سلسلے میں ہم FASTQ فائلوں اور quality scores، درست human reference genome کے انتخاب، اور VCF فائل پڑھنے پر بات کر چکے ہیں۔ یہ رہنما درمیان کا خلا پُر کرتا ہے۔ جب BWA-MEM، Bowtie2 یا minimap2 جیسا aligner ہر read کو reference پر اس کی جگہ رکھ دیتا ہے تو نتیجہ SAM، BAM یا CRAM فائل میں محفوظ ہوتا ہے۔ یہ عموماً کسی sequencing منصوبے کی سب سے بڑی فائلیں ہوتی ہیں، اور variant calling سے لے کر RNA-seq counting تک تقریباً ہر اگلا قدم انہی کو پڑھتا ہے۔
انہیں سمجھنے کا یہ مناسب وقت بھی ہے۔ 27 اکتوبر 2026 کو HTSlib (وہ C library جس پر samtools اور bcftools چلتے ہیں) کے ماہرین نے ورژن 1.25 جاری کیا جس میں کئی security خامیاں درست کی گئیں، جن میں سے کچھ alignment index فائلیں پڑھنے والے کوڈ میں تھیں۔ عام صارف کے لیے اس کا کیا مطلب ہے، یہ ہم آخر میں دیکھیں گے۔
فہرست
- ایک ہی ڈیٹا، تین شکلیں
- Header: @ سے شروع ہونے والی لائنیں
- گیارہ لازمی کالم
- FLAG کو کیسے سمجھیں
- CIGAR string کیسے پڑھیں
- MAPQ اور base quality ایک چیز نہیں
- جاننے کے قابل optional tags
- samtools سے مختصر اور قابلِ تکرار جانچ
- چھ عام غلطیاں
- HTSlib کو ابھی اپ ڈیٹ کرنا کیوں ضروری ہے
- Alignment فائل کیا نہیں بتا سکتی
- عملی چیک لسٹ
ایک ہی ڈیٹا، تین شکلیں
SAM، BAM اور CRAM تینوں ایک جیسی معلومات رکھتی ہیں: ایک header اور ہر read alignment کا ایک record۔ فرق صرف یہ ہے کہ یہ معلومات disk پر کیسے لکھی جاتی ہیں۔
- SAM (Sequence Alignment/Map) سادہ tab-separated text ہے۔ اسے
lessسے پڑھا جا سکتا ہے، مگر یہ بڑی اور سست ہوتی ہے۔ - BAM انہی records کی binary اور BGZF سے compressed شکل ہے۔ روزمرہ کام اسی پر ہوتا ہے، اور اسے index (
.baiیا.csi) کیا جا سکتا ہے تاکہ tools کسی بھی genomic region تک براہِ راست پہنچ سکیں۔ - CRAM مزید compression کے لیے ہر base لکھنے کے بجائے زیادہ تر یہ محفوظ کرتی ہے کہ read، reference سے کہاں مختلف ہے۔ فائلیں اکثر BAM سے کافی چھوٹی ہوتی ہیں، لیکن انہیں کھولنے کے لیے بالکل وہی reference sequence چاہیے جس سے وہ لکھی گئی تھیں۔ اس کا index
.craiہوتا ہے۔
یہ تینوں GA4GH کے Large Scale Genomics گروپ کی کھلی specifications سے متعین ہیں: SAMv1 دستاویز SAM، BAM اور BAI index کا احاطہ کرتی ہے، اور CRAMv3 کی الگ دستاویز CRAM کا۔

Header: @ سے شروع ہونے والی لائنیں
VCF کی ## لائنوں کی طرح header بھی ڈیٹا کا حصہ ہے، سجاوٹ نہیں۔ اہم لائنیں یہ ہیں:
@HD: فارمیٹ ورژن (VN) اور sort order (SO:coordinate،querynameیاunsorted)۔@SQ: ہر reference sequence کی ایک لائن، جس میں نام (SN)، لمبائی (LN) اور اکثر MD5 checksum (M5) ہوتا ہے۔ انہی سے پتا چلتا ہے کہ coordinates کس reference build کے ہیں۔@RG: read groups، جو reads کو sample (SM)، library (LB) اور platform (PL) سے جوڑتے ہیں۔ Variant callers ان پر انحصار کرتے ہیں۔@PG: وہ programs اور commands جنہوں نے فائل بنائی یا بدلی، یعنی فائل کے اندر ہی اس کی تاریخ۔
گیارہ لازمی کالم
یہ ایک paired read اور ایک single read کی چھوٹی، فرضی مثال ہے:
@HD  VN:1.6  SO:coordinate
@SQ  SN:chr1  LN:248956422
@RG  ID:lib1  SM:SAMPLE1  PL:ILLUMINA
@PG  ID:bwa  PN:bwa  CL:bwa mem GRCh38.fa R1.fq.gz R2.fq.gz
read001  99   chr1  1000  60  20M        =  1181  201   ACGTTGCAAGTCCGATTGCA  IIIIIIIIIIIIIIIIIIII  NM:i:0  RG:Z:lib1
read001  147  chr1  1181  60  20M        =  1000  -201  TTGACCGTAGGCATCAAGTC  IIIIIIIIIIIIIIIIIIII  NM:i:0  RG:Z:lib1
read002 0 chr1 2050 23 4S10M2I4M * 0 0 GGATCCTAGCTTACGAAGTT IIIII?????IIIIIIIIII NM:i:2 RG:Z:lib1- QNAME: read (template) کا نام۔ ایک pair کے دونوں mates کا نام ایک ہی ہوتا ہے۔
- FLAG: ایک عدد جس کے bits read کے بارے میں بتاتے ہیں (نیچے وضاحت ہے)۔
- RNAME: reference sequence کا نام، جو کسی
@SQلائن سے میل کھاتا ہے۔ - POS: read کے align ہونے والے حصے کا سب سے بائیں reference مقام، 1-based۔ Soft-clipped bases اس میں شمار نہیں ہوتے۔
- MAPQ: mapping quality (نیچے وضاحت ہے)۔
- CIGAR: read، reference کے ساتھ کیسے align ہوا۔
- RNEXT اور 8۔ PNEXT: mate کا reference اور مقام (
=یعنی وہی کروموسوم؛*اور0یعنی دستیاب نہیں)۔ - TLEN: template (fragment) کی مشاہدہ شدہ لمبائی؛ بائیں mate کے لیے مثبت اور دوسرے کے لیے منفی۔
- SEQ: read کے bases، ہمیشہ reference کے forward strand کے لحاظ سے۔
- QUAL: base qualities، اسی Phred+33 encoding میں جو FASTQ میں ہوتی ہے۔
FLAG کو کیسے سمجھیں
FLAG مختلف bits کا مجموعہ ہوتا ہے۔ عام bits یہ ہیں:
1paired؛2proper pair میں mapped؛4read unmapped؛8mate unmapped16read reverse strand پر؛32mate reverse strand پر64pair کا پہلا read؛128pair کا دوسرا read256secondary alignment؛512QC میں ناکام؛1024PCR یا optical duplicate؛2048supplementary alignment
یوں 99 = 1 + 2 + 32 + 64 کا مطلب ہے: paired، proper pair والا پہلا read جس کا mate reverse strand پر ہے۔ اس کا ساتھی 147 = 1 + 2 + 16 + 128 reverse strand پر دوسرا read ہے۔ یہ حساب ہاتھ سے کرنے کی ضرورت نہیں: samtools flags 99 اس کا مطلب لکھ دیتا ہے۔
CIGAR string کیسے پڑھیں
CIGAR لمبائیوں اور operations کی فہرست ہے۔ سب سے عام یہ ہیں: M (aligned، جو match یا mismatch دونوں ہو سکتا ہے)، I (reference کے مقابلے میں insertion)، D (deletion)، N (reference کا چھوڑا گیا حصہ، عموماً RNA-seq میں intron)، S (soft clip: bases SEQ میں موجود مگر align نہیں)، H (hard clip: bases SEQ سے نکال دیے گئے)، اور = / X (واضح match / mismatch)۔
مثال میں 4S10M2I4M کا مطلب ہے: پہلے 4 bases soft-clipped ہیں، پھر 10 align ہوئے، 2 bases insert ہوئے، اور مزید 4 align ہوئے۔ Read کی لمبائی 20 ہے مگر یہ reference کے صرف 14 bases کو ڈھانپتا ہے۔ چونکہ M mismatches کو چھپا لیتا ہے، اس لیے فرق کی تعداد NM tag (edit distance) یا MD tag میں دیکھی جاتی ہے۔
MAPQ اور base quality ایک چیز نہیں
MAPQ ایک Phred-scaled اندازہ ہے کہ read غلط جگہ پر رکھا گیا ہے: MAPQ 20 کا مطلب تقریباً 100 میں سے 1 امکان، اور MAPQ 60 کا تقریباً دس لاکھ میں سے 1۔ یہ سوال کا جواب دیتا ہے کہ “کیا جگہ درست ہے؟”، نہ کہ “bases درست ہیں؟” یا “alignment کتنا اچھا ہے؟”۔ عملی طور پر ہر aligner MAPQ کو اپنے طریقے سے حساب کرتا ہے؛ 0 عموماً اس read کی نشانی ہے جو کئی جگہوں پر برابر فٹ ہوتا ہے (repeats میں عام)، اور 255 کا مطلب ہے کہ قدر دستیاب نہیں۔ MAPQ کی حدیں صرف ایک ہی aligner کے اندر موازنہ کریں۔
جاننے کے قابل optional tags
گیارہویں کالم کے بعد TAG:TYPE:VALUE شکل کے fields آتے ہیں۔ معیاری tags میں NM (edit distance)، MD (mismatch کے مقامات)، AS (alignment score)، RG (read group)، SA (chimeric یا split read کے باقی حصے) اور MM/ML (methylation جیسی base modifications، جو long-read ڈیٹا میں بڑھتی جا رہی ہیں) شامل ہیں۔ X، Y یا Z سے شروع ہونے والے tags مقامی استعمال کے لیے مخصوص ہیں، اس لیے ان کا مطلب لکھنے والے tool پر منحصر ہے۔
samtools سے مختصر اور قابلِ تکرار جانچ
اگر samtools نصب ہو (مثلاً WSL2 والے سیٹ اپ میں)، تو یہ commands ابتدائی جانچ کا بیشتر کام کر دیتی ہیں:
# Which samtools and HTSlib versions am I running?
samtools --version

# Is the file intact (truncation, missing EOF block)?
samtools quickcheck -v sample.bam && echo "OK"

# Header: sort order, reference contigs, read groups, programs
samtools view -H sample.bam | less -S

# Sort by coordinate and index
samtools sort -@ 4 -o sample.sorted.bam sample.bam
samtools index sample.sorted.bam

# Quick summaries
samtools flagstat sample.sorted.bam
samtools idxstats sample.sorted.bam
samtools stats sample.sorted.bam > qc/sample.stats.txt

# Count primary, mapped reads with MAPQ >= 20
# (0x904 excludes unmapped, secondary and supplementary records)
samtools view -c -q 20 -F 0x904 sample.sorted.bam

# Look at one region
samtools view sample.sorted.bam chr1:1000000-1001000 | head

# Convert to CRAM against the same reference, then index
samtools view -C -T GRCh38.fa -o sample.cram sample.sorted.bam
samtools index sample.cram
Duplicate marking کے لیے samtools کی دستاویزات collate ← fixmate -m ← sort ← markdup کا سلسلہ بتاتی ہیں۔ VCF کی طرح یہاں بھی tools کے ورژن، reference FASTA اور اس کا checksum، اور ہر command نتائج کے ساتھ محفوظ رکھیں۔
چھ عام غلطیاں
- CRAM کا reference کھو دینا یا بدل دینا۔ مختلف FASTA سے کھولی گئی CRAM غلط bases دیتی ہے یا کھلتی ہی نہیں۔ بالکل وہی reference محفوظ رکھیں (
@SQمیںM5checksums اس کی تصدیق میں مدد دیتے ہیں)، اور contig ناموں کا میل (chr1بمقابلہ1) بھی دیکھیں۔ - لائنیں گن کر reads شمار کرنا۔ ایک read کے secondary اور supplementary records بھی ہو سکتے ہیں، اور unmapped reads اکثر فائل میں موجود رہتے ہیں۔ گننے سے پہلے FLAG کے ذریعے filter کریں۔
- مختلف aligners کے MAPQ کا موازنہ۔ جو حد ایک tool کے لیے مناسب ہو، وہ دوسرے کے لیے بے معنی ہو سکتی ہے۔
- Unsorted فائل یا پرانا index استعمال کرنا۔ Region queries کے لیے coordinate-sorted فائل اور اس کی آخری تبدیلی کے بعد بنایا گیا index چاہیے۔
- Duplicates کو نظرانداز کرنا۔ PCR duplicates coverage کو بڑھا چڑھا کر دکھاتے ہیں اور sequencing کی غلطی کو بھی مضبوط ویریئنٹ جیسا بنا سکتے ہیں۔
- دوسروں کی فائلوں پر پرانے tools چلانا۔ اگلا حصہ دیکھیں۔
HTSlib کو ابھی اپ ڈیٹ کرنا کیوں ضروری ہے
27 اکتوبر 2026 کی advisory میں HTSlib کے ماہرین نے ورژن 1.24 اور اس سے پرانے ورژنز میں کئی خامیاں بتائیں۔ دو کو high severity قرار دیا گیا: ایک .bai، .csi اور .tbx index فائلیں پڑھنے والے کوڈ میں، اور ایک VCF reader میں جب اسے کچھ کالم چھوڑنے کے لیے استعمال کیا جائے۔ باقی moderate یا low درجے کی ہیں۔ یہ سب HTSlib 1.25 میں درست کی گئی ہیں اور 1.24.1، 1.23.3، 1.22.4 اور 1.21.3 میں بھی شامل کی گئی ہیں؛ advisory کے مطابق ان کا کوئی متبادل حل (workaround) نہیں۔ 2026 کی پچھلی releases میں CRAM decoding کی خامیاں بھی الگ سے درست کی گئی تھیں۔
آسان الفاظ میں، جان بوجھ کر بنائی گئی کوئی فائل tool کو crash کر سکتی ہے اور بدترین صورت میں ممکنہ طور پر کوڈ چلانے کے لیے بھی استعمال ہو سکتی ہے۔ زیادہ تر قارئین کے لیے مناسب اقدامات یہ ہیں: samtools --version چلائیں، package manager یا conda کے ذریعے patched ورژن پر اپ ڈیٹ کریں، نامعلوم ذرائع سے آنے والی alignment اور index فائلوں کے ساتھ احتیاط کریں، اور مشترکہ servers پر ایسی فائلیں administrator اختیارات کے ساتھ process نہ کریں۔
Alignment فائل کیا نہیں بتا سکتی
BAM فائل آپ کے منتخب کردہ reference کی بنیاد پر aligner کا بہترین اندازہ محفوظ کرتی ہے۔ Repeats اور segmental duplications، وہ علاقے جہاں reference آپ کے sample سے مختلف ہو، contamination اور library کی خرابیاں، سب پُراعتماد نظر آنے والی مگر غلط placements پیدا کر سکتی ہیں۔ IGV جیسے viewer میں reads دیکھنا، coverage اور duplicate rate جانچنا، اور مشکل علاقوں میں aligners کا موازنہ کرنا اچھی عادتیں ہیں۔ Clinical ماحول میں لیبارٹریاں validated pipelines استعمال کرتی ہیں اور اہم نتائج کی تصدیق کرتی ہیں، مثلاً Sanger sequencing کے ذریعے۔
عملی چیک لسٹ
- کسی بھی کام سے پہلے
samtools quickcheckچلائیں اور header پڑھیں۔ @SQلائنوں میں reference build اور contig ناموں کی تصدیق کریں۔- ہر CRAM کے ساتھ بالکل وہی reference FASTA محفوظ رکھیں۔
- Sort order دیکھیں اور ہر تبدیلی کے بعد index دوبارہ بنائیں۔
- FLAGs کو
samtools flagsسے سمجھیں؛ گننے سے پہلے secondary اور supplementary records الگ کریں۔ - MAPQ کی حد ہر aligner کے لیے الگ طے کریں اور اسے دستاویزی شکل دیں۔
- Patched HTSlib/samtools ورژن استعمال کریں (1.25، یا 1.21.3 تا 1.24.1 میں سے کوئی backport)۔
تحقیقی و تعلیمی وضاحت: یہ مضمون فائل فارمیٹس کی وضاحت ہے، طبی مشورہ نہیں۔ صرف alignment فائلوں کی بنیاد پر تشخیص، علاج یا genetic counselling سے متعلق فیصلے نہ کریں۔
نمایاں تصویر: Galaxy Training Network کے tutorial “Mapping” سے read mapping کا خاکہ، از Joachim Wolff، Bérénice Batut اور Helena Rasche، CC BY 4.0۔
حوالہ جات
- Sequence Alignment/Map Format Specification (SAMv1), samtools/hts-specs
- Sequence Alignment/Map Optional Fields Specification (SAMtags)
- CRAM format specification (version 3.x)
- Li H, et al. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 2009;25(16):2078–2079. doi:10.1093/bioinformatics/btp352
- Hsi-Yang Fritz M, et al. Efficient storage of high throughput DNA sequencing data using reference-based compression. Genome Research. 2011;21(5):734–740. doi:10.1101/gr.114819.110
- Bonfield JK, et al. HTSlib: C library for reading/writing high-throughput sequencing data. GigaScience. 2021;10(2):giab007. doi:10.1093/gigascience/giab007
- Danecek P, et al. Twelve years of SAMtools and BCFtools. GigaScience. 2021;10(2):giab008. doi:10.1093/gigascience/giab008
- Multiple vulnerabilities in HTSlib <= 1.24 (oss-security advisory, 27 October 2026)
- HTSlib 1.25 release notes
- samtools manual

A molecular biologist and aspiring bioinformatician with a passion for genomics, rare diseases, and precision medicine. With an MPhil in Molecular Biology and experience in genetics and genomics, he has contributed to clinical research projects on rare genetic disorders. He’s passionate about making genomic data meaningful — and ultimately helpful — for patients and clinicians alike.


Leave a Reply